
Eine Methode zur Operationalisierung der KI-Definition gemäß EU KI-Verordnung
Seit Wochen arbeite ich an der Operationalisierung der KI-Definition gemäß der europäischen KI-Verordnung (KI-VO). Eigentlich sollte man meinen, dass genau dieser Teil besonders klar geregelt ist – doch in der Praxis zeigt sich ein anderes Bild.
Seit Wochen arbeite ich an der Operationalisierung der KI-Definition gemäß der europäischen KI-Verordnung (KI-VO). Eigentlich sollte man meinen, dass genau dieser Teil besonders klar geregelt ist – doch in der Praxis zeigt sich ein anderes Bild. Immer wieder stoße ich auf grundlegende Abgrenzungsprobleme, die die Anwendung der Verordnung erheblich erschweren.
- Die KI-VO definiert Systeme – allerdings nicht mit der notwendigen Klarheit. Im Kern geht es in der Verordnung um KI-Systeme, nicht um Methoden. Dennoch werden in den begleitenden Leitlinien einzelne Methoden wie die logistische Regression explizit als Ausnahme aufgeführt – obwohl es sich dabei zweifelsohne um eine etablierte KI-Methode handelt.
- „Ableiten“ ist nicht gleich „Ableiten“. Auch das zentrale Abgrenzungskriterium erweist sich bei näherer Betrachtung als problematisch, denn „Ableiten“ ist nicht gleich „Ableiten“. Die Verordnung vermischt hier zwei unterschiedliche Dimensionen: Zum einen die Frage, wie ein System überhaupt konstruiert wurde, um ableiten zu können. Zum anderen die Frage, wie es sich im operativen Betrieb verhält.
- Die KI-VO stellt Schein-Kriterien auf. Hinzu kommt, dass die Verordnung Kriterien enthält, die auf den ersten Blick trennscharf wirken, in der Praxis jedoch kaum Abgrenzungswirkung entfalten. Begriffe wie „maschinengestützt“, „Beeinflussung physischer oder virtueller Umgebungen“ oder „zielorientiertes Arbeiten“ treffen faktisch auf nahezu jedes IKT-System zu. Damit verlieren diese Kriterien ihren eigentlichen Zweck.
In der Praxis führt das zwangsläufig zu Missverständnissen und Fehleinschätzungen – nicht zuletzt deshalb, weil vermutlich viele kurzfristig „ernannte“ KI-Beauftragte eigentlich nur wenig fachlichen Bezug zu diesem hochkomplexen Thema haben.
Auch ich merke, wie herausfordernd der Wiedereinstieg ist. Meine „Grundausbildung“ im Bereich „Advanced Methods of Artificial Intelligence“ liegt inzwischen über 15 Jahre zurück. Und obwohl ich auf ein fachliches Fundament aufsetzen kann, bleibt der Zugang zu diesem Thema anspruchsvoll. Ich frage mich daher oft, wie es wohl Kolleginnen und Kollegen geht, die diesen Hintergrund nicht mitbringen.
Und dann kommt da noch eine ganz praktische Herausforderung hinzu: Wir bewerten nicht einzelne IKT-Systeme sondern müssen komplexe IT-Landschaften mit einer Vielzahl von Systemen analysieren. Gleichzeitig fehlt uns häufig die notwendige Transparenz über die interne Funktionsweise der Systeme, denn welcher Softwarehersteller gewährt schon freiwillig einen detaillierten Einblick in seine Modelle und Algorithmen?
Während also der Rest der Welt mit Vollgas neue KI-Tools entwickelt und sie in Wirkung bringt, sitzen viele von uns noch am Schreibtisch und quälen sich mit der regulatorisch korrekten Auslegung der KI-Definition und der Überprüfung bestehender IKT-Systeme.
Das muss sich ändern! Das muss smarter gehen!
Und deshalb habe ich in den letzten Wochen meine DORA-Werkstatt ein wenig umgebaut und eine größere Ecke für meine KI-Werkstatt freigeräumt:D
Die Mission: Eine Methode zur Operationalisierung der KI-DefinitionAktuelle Zielstellung in meiner KI-Werkstatt: Eine Methode zu erarbeiten, die dabei hilft, die KI-Definition nach Art. 3 Nr. 1 KI-VO zu operationalisieren.
Der Zusatzauftrag: Ein KI-Chatbot, der die Arbeit erledigt!Idealerweise kann ich diese Methode so gestalten, dass ich sie einem KI-Chatbot beibringen kann, der zukünftig die Hausaufgaben erledigt. In wenigen Stunden anstatt in mehreren Mann-Monaten!
Die Herausforderung: Die regulatorische Konformität.Um sicherzustellen, dass die Methode den regulatorischen Anforderungen standhält, braucht sie klare Prüfkriterien, die sich transparent aus der regulatorischen Definition ableiten lassen sowie eine nachvollziehbare und erklärbare Entscheidungslogik.
Die gesetzliche KI-Definition
Die gesetzliche Definition nach Art. 3 Nr. 1 KI-VO: Ein Satz, fünf Kommas, acht Elemente und eine zentrale Frage: Welche IKT-Systeme fallen darunter?
„KI-System“ — ein maschinengestütztes System, das für einen in unterschiedlichem Grade autonomen Betrieb ausgelegt ist und das nach seiner Betriebsaufnahme anpassungsfähig sein kann und das für explizite oder implizite Ziele aus den erhaltenen Eingaben ableitet, wie Ergebnisse wie etwa Vorhersagen, Inhalte, Empfehlungen oder Entscheidungen erstellt werden, die physische oder virtuelle Umgebungen beeinflussen können.“
Wenn man diesen Satz auseinandernimmt, stecken darin acht Dinge, die ein System können soll, um als KI-System zu gelten:
- Daten maschinengestützt verarbeiten,
- teilweise autonom arbeiten,
- anpassungsfähig sein,
- Ziele verfolgen,
- Eingaben erfassen,
- Ableitungen treffen,
- Ergebnisse erzeugen und
- Umgebungen beeinflussen.
Das Problem: Diese acht Elemente sind nicht gleich wichtig
„Maschinengestützt“ trifft auf jedes IKT-System zu. „Zielorientiert“ ebenso. „Umgebungen beeinflussen“ — welches System tut das nicht? Wer alle acht Elemente gleichwertig prüft, verschwendet Zeit und kommt vermutlich auch nur mühsam zum Ziel.
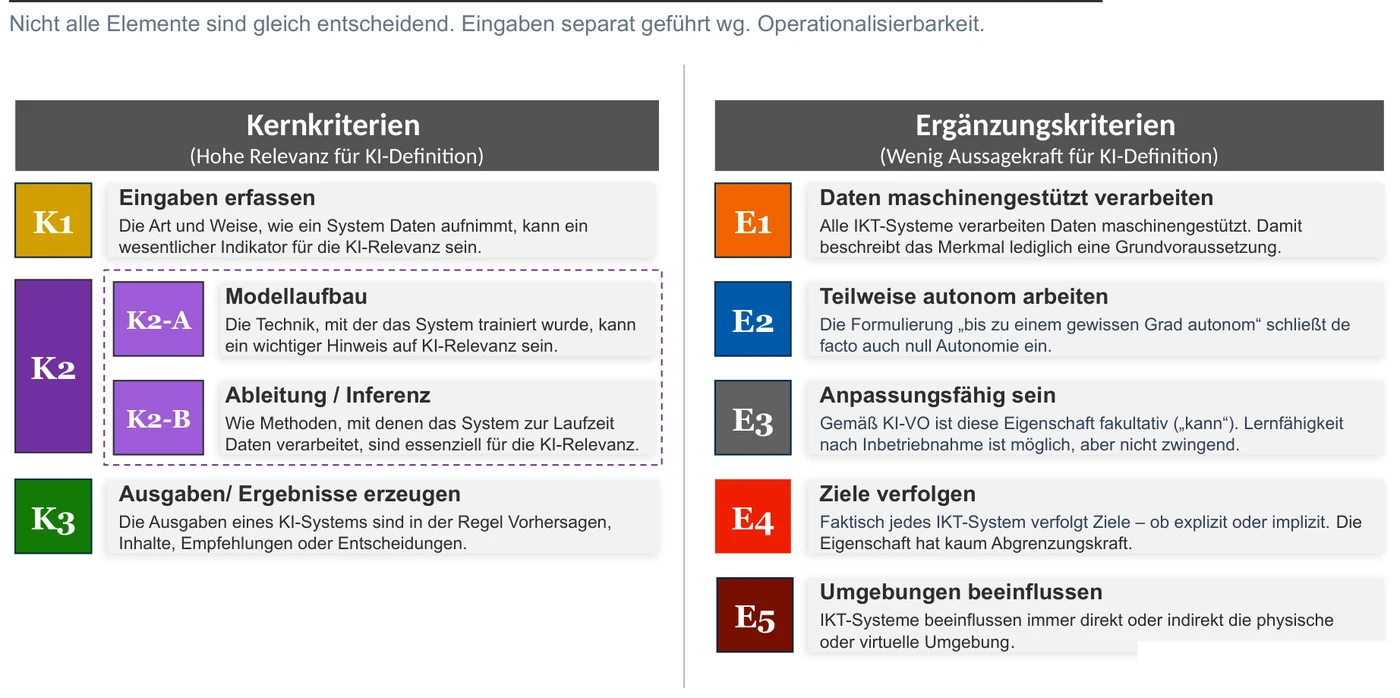
Deshalb habe ich die acht Elemente zunächst in zwei Gruppen getrennt: Kernkriterien (K), die tatsächlich entscheiden — und Ergänzungskriterien (E), die fast immer erfüllt sind und bestenfalls bei Grenzfällen weiterhelfen.
Demnach bestimmen folgende drei — eigentlich vielmehr vier — Kernkriterien die Einstufung:
- K1 – Wie erfasst das System Eingaben? Die Art und Weise, wie ein IKT-System Daten aufnimmt, kann ein wesentlicher Indikator für die KI-Relevanz sein.
- K2 – Wie erfolgt die Ableitung? Hier steckt der Teufel im Detail, denn „Ableiten“ hat gemäß KI-VO eigentlich zwei Dimensionen. Es geht sowohl darum, wie ein System gebaut wurde, damit es überhaupt ableiten kann (K2-A: Modellaufbau) — als auch darum, wie es im Betrieb tatsächlich arbeitet, also ableitet (K2-B: Ableitung/Inferenz).
- K3 – Welche Ausgaben erzeugt das System? Die Ausgaben eines KI-Systems können beispielsweise Vorhersagen, Inhalte, Empfehlungen oder Entscheidungen sein.
Die restlichen fünf Elemente haben eigentlich kaum Abgrenzungskraft! Dennoch erfordert die Einstufung als KI-System natürlich eine Gesamtabwägung aller Kriterien.
Vom Input zum Output: Zwei KI-Technikfamilien
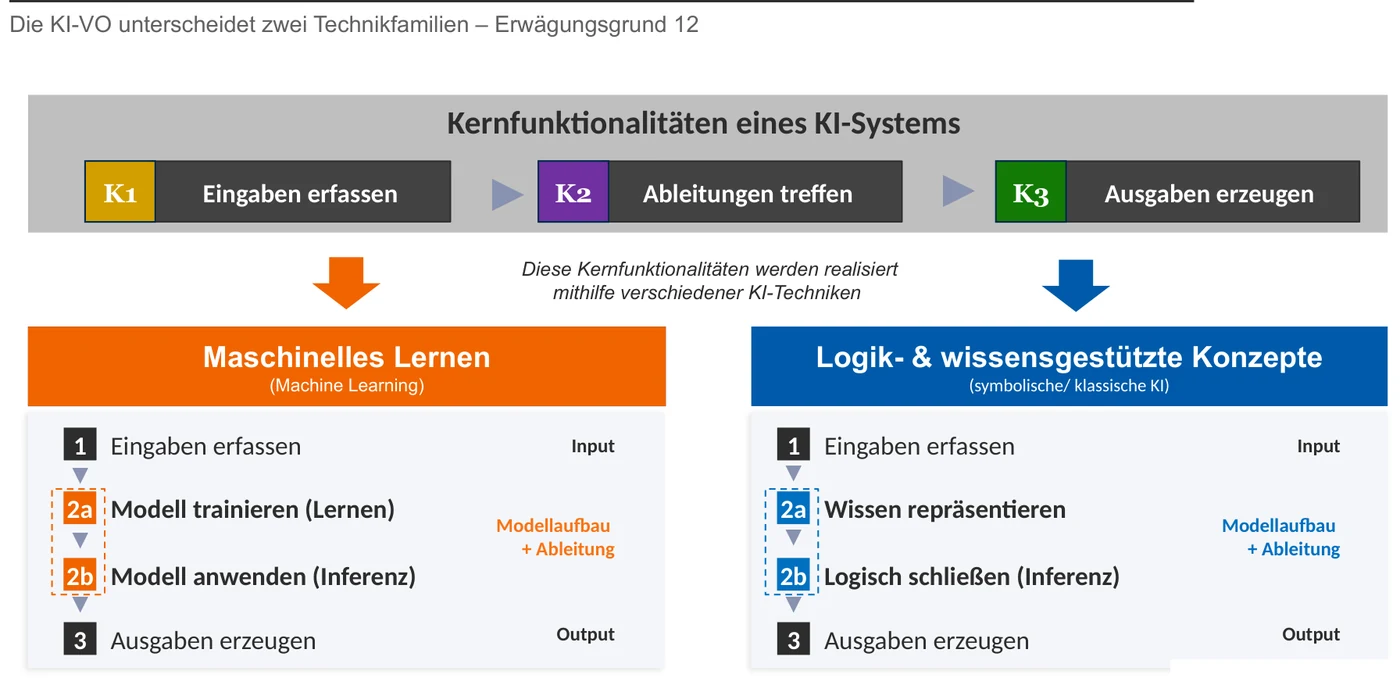
Die KI-VO unterscheidet außerdem in Erwägungsgrund 12 zwei Technikfamilien, die ein klassisches IKT-System zu einem KI-System werden lassen:
- Maschinelles Lernen, und
- logik- und wissensgestützte Konzepte.
So unterschiedlich diese Ansätze auch sind – im Kern durchlaufen beide denselben Dreischritt: Eingabe → Ableitung → Ausgabe
Die Eingabe (K1)
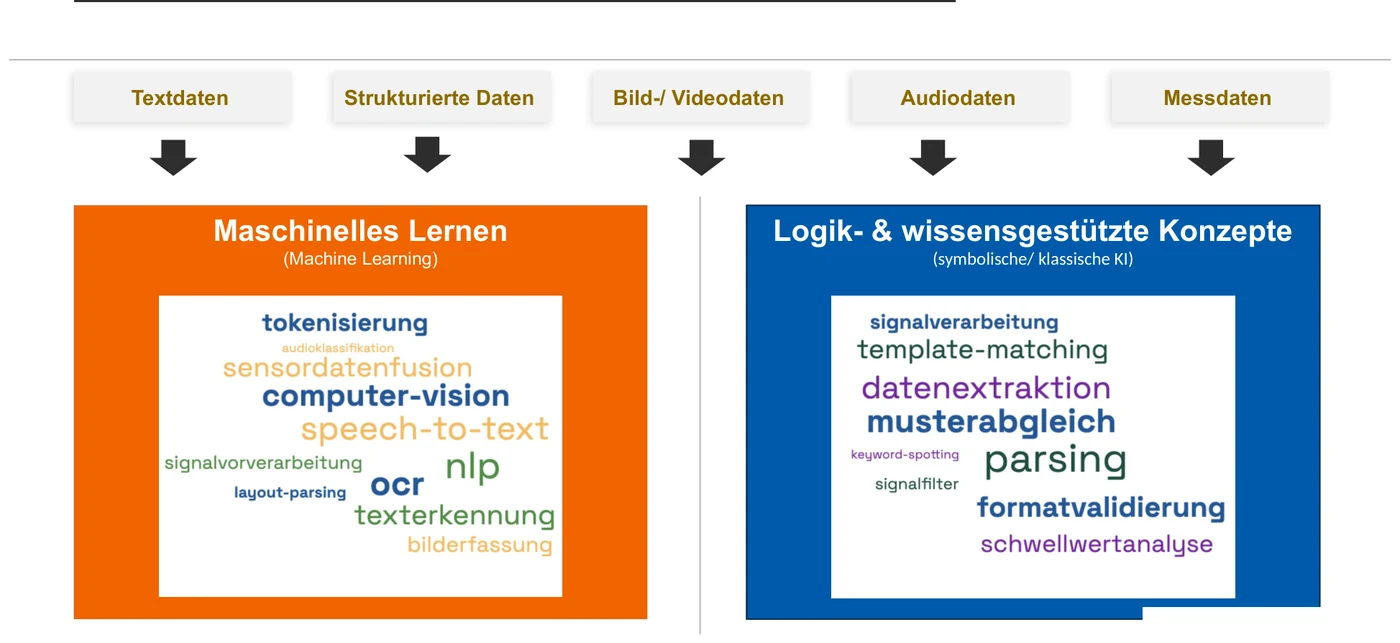
Beginnen wir mit dem ersten Schritt: der Eingabe. Wie alle IKT-Systeme benötigen auch KI-Systeme Daten, um überhaupt arbeiten zu können. Bereits an dieser Stelle lässt sich in der Praxis aber oft schon eine erste Einordnung vornehmen, den die Eingabe-Datentypen geben bereits einen ersten Hinweis darauf, wie wahrscheinlich der Einsatz von KI-Methoden ist.
Strukturierte Daten oder einfache Textdaten können grundsätzlich von nahezu jedem System verarbeitet werden. Anders sieht es bei Bild-, Audio- oder Videodaten aus. Hier steigt die Wahrscheinlichkeit deutlich, dass spezialisierte KI-Methoden wie Computer Vision oder Natural Language Processing zum Einsatz kommen.
Die Ausgabe (K3)
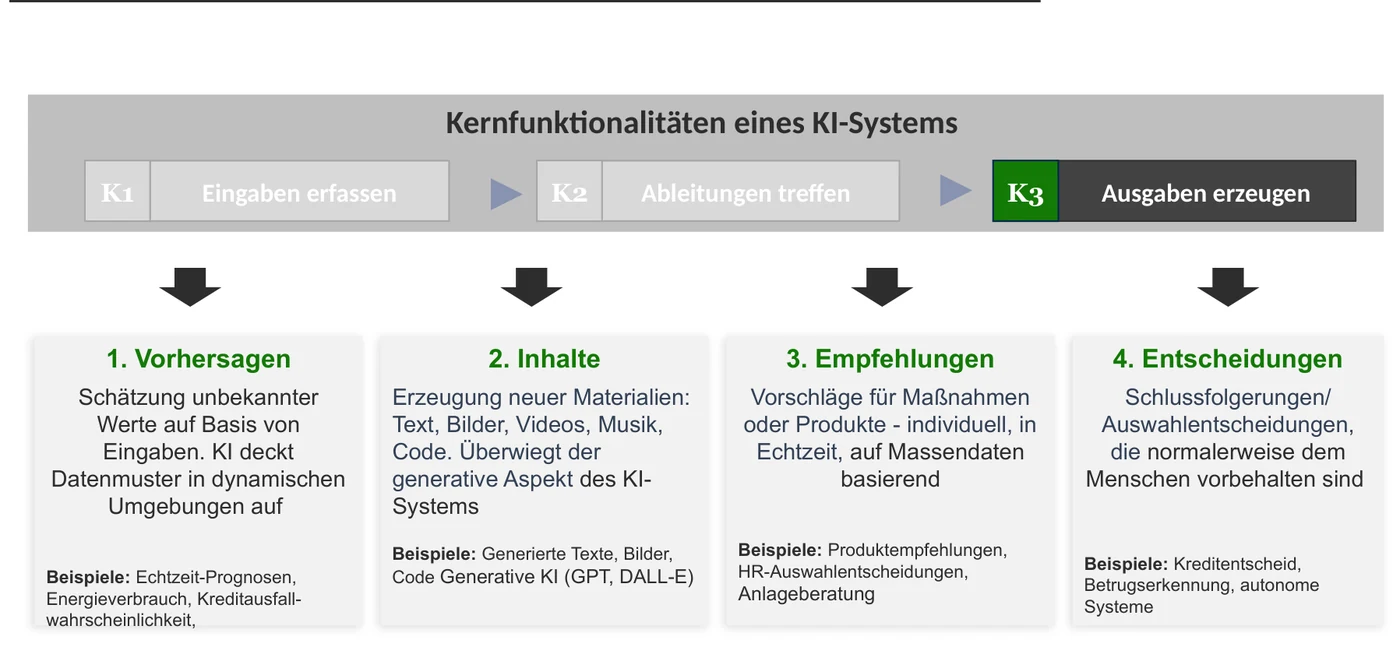
Bevor wir uns dem Thema Ableitung widmen, will ich erst noch auf den deutlich einfacheren Schritt der Ausgabe eingehen. Gemäß KI-VO sind Systeme dann KI, wenn sie Vorhersagen, Inhalte, Empfehlungen oder Entscheidungen ausgeben. Einfache Kalkulationsprogramme oder Textverarbeitungsprogramme sind also nicht gemeint.
Um das etwas greifbarer zu machen, habe ich eine kleine Erläuterung und einige Beispiele zu diesen Ausgabekategorien ergänzt.
Die Ableitung (K2)
Nun wird es anspruchsvoll, denn das Kriterium der Ableitungsfähigkeit ist nach meiner Auffassung das schwierigste bei der KI-Definition. Denn wer weiß denn schon genau, ob ein System während seiner Entwicklung mit klassischen logik- und wissensgestützten Konzepten erstellt oder mit Machine Learning trainiert wurde? Und wer kann eigentlich genau beantworten, ob das System mithilfe von Machine-Learning-Methoden ableitet oder mithilfe klassischer Algorithmen Muster erkennt, Schlussfolgerungen zieht und Probleme löst?
Beispielsweise könnte ein Kreditscoring auf Machine Learning trainiert sein, im Betrieb aber nur noch eine feste Formel anwenden. Ist das noch „Ableiten“ im Sinne der KI-VO, oder handelt es sich dabei um „Standard-Datenverarbeitung“?
Der Modellaufbau (K2-A)
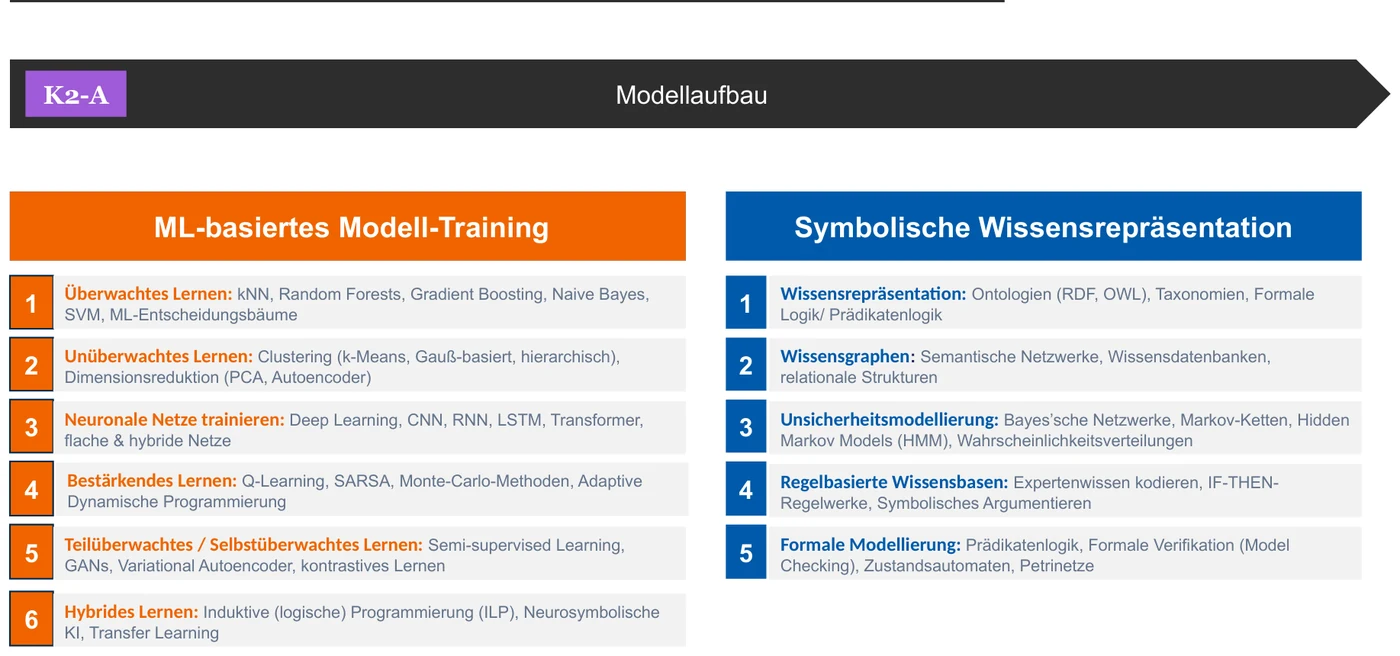
Die erste Dimension der Ableitungsfähigkeit betrifft den Modellaufbau: Wie wurde das System entwickelt? Wurden Trainingsdaten verwendet, aus denen das System Muster gelernt hat, oder wurde Expertenwissen systematisch kodiert? Beide Ansätze stellen nach der KI-Verordnung Wege dar, die eine Ableitung von Ergebnissen überhaupt erst ermöglichen.
Um dieses Kriterium greifbarer zu machen, habe ich für jede Technikfamilie die wesentlichen Methoden des Modellaufbaus sowie der Formalisierung des zugrunde liegenden Wissens zusammengetragen. Während im Machine Learning die bekannten datengetriebenen Lernverfahren im Vordergrund stehen, kommen bei logik- und wissensbasierten Konzepten klassische Formen der symbolischen Wissensrepräsentation zum Einsatz.
Das Ableiten (K2-B)
Die zweite Dimension der Ableitungsfähigkeit betrifft den Betrieb des Systems. Hier geht es um die Frage, ob das System „echte“ Ableitungsfähigkeiten besitzt. Doch was genau ist damit eigentlich gemeint?
Um mich dieser Frage weiter zu nähern, habe ich auf Basis einer Literaturrecherche eine Auslegungshilfe zur KI-VO erstellt, die den Ableitungsbegriff konkretisiert. Dabei habe ich mich auf sieben verschiedene Ableitungsformen festgelegt, mit denen sich deutlich besser beschreiben lässt, was ein System eigentlich „unter der Motorhaube“ tut, wenn wir von „Ableiten“ sprechen.
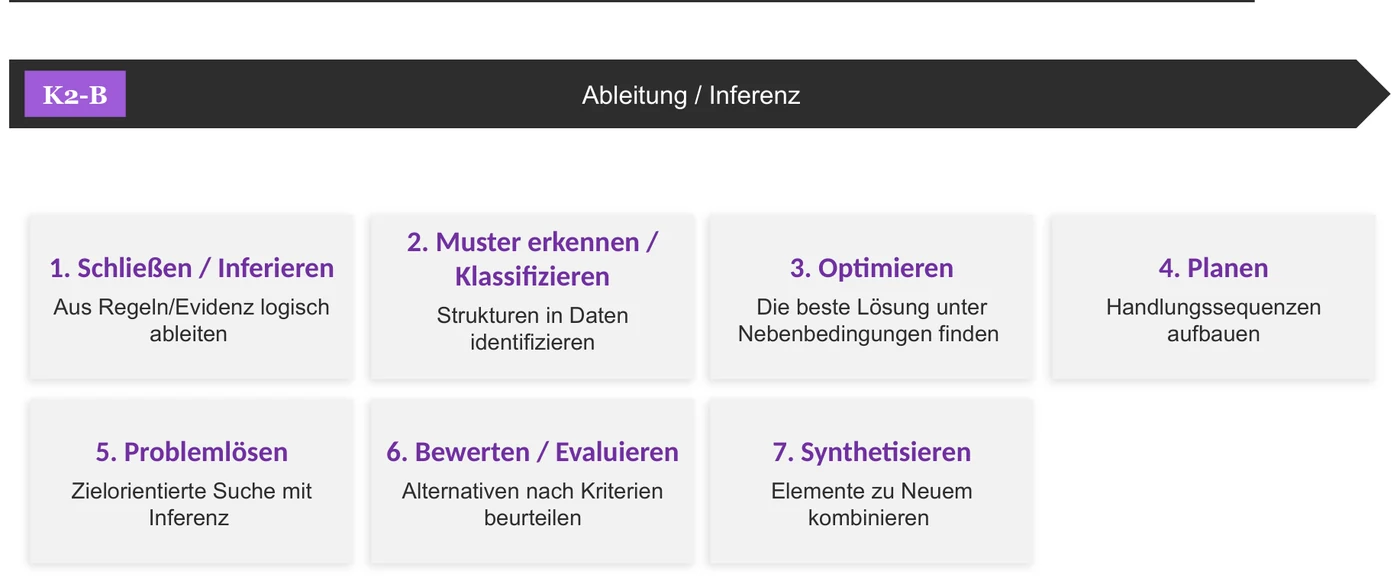
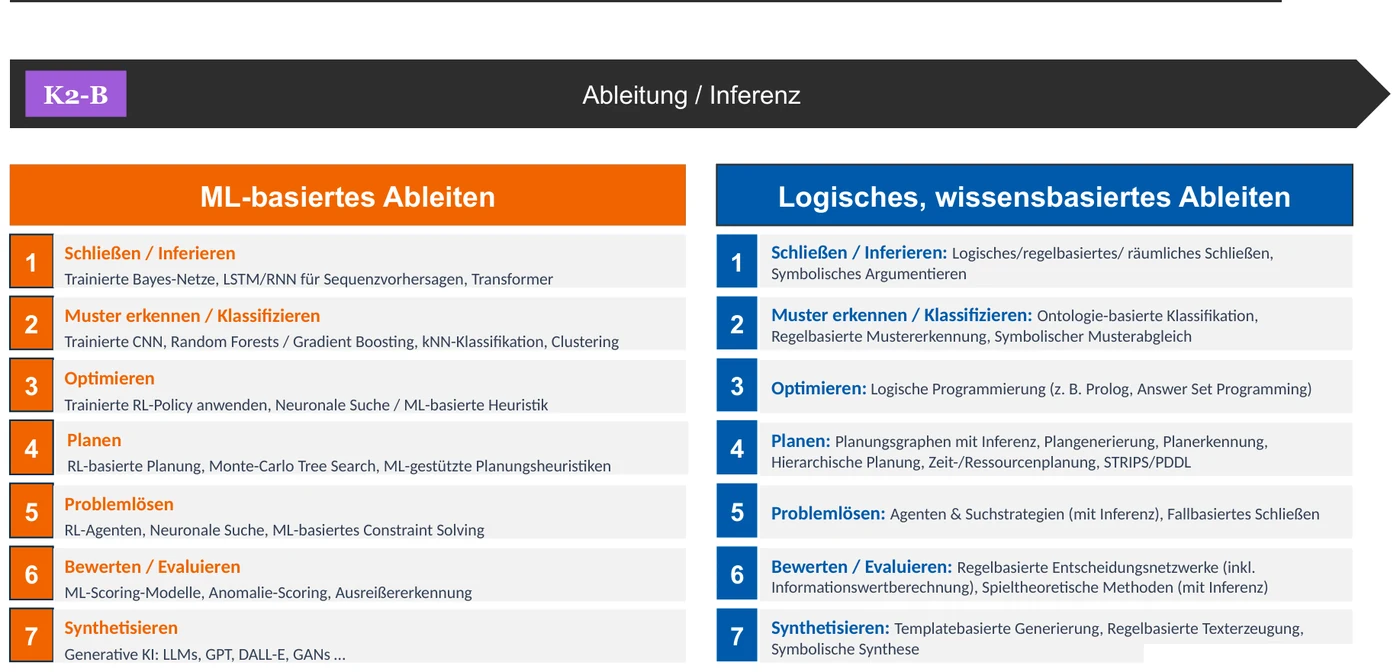
Diese Ableitungsformen haben in den beiden KI-Technikfamilien klare algorithmische Gegenstücke. So basiert das „Schließen/Inferieren“ bei logik- und wissensgestützten Konzepten auf Methoden des logischen oder regelbasierten Schließens, während sich auf der Machine-Learning-Seite KI-Methoden wie trainierte Bayes-Netze oder neuronale Netze finden.
Wie genau diese Algorithmen im Detail arbeiten, müssen letztlich die KI-Entwickler beantworten. Für meine Zwecke genügt jedoch die Einordnung, dass diese Methoden grundsätzlich dazu geeignet sind, die jeweiligen Formen des Ableitens zu realisieren.
Was ist kein Ableiten?
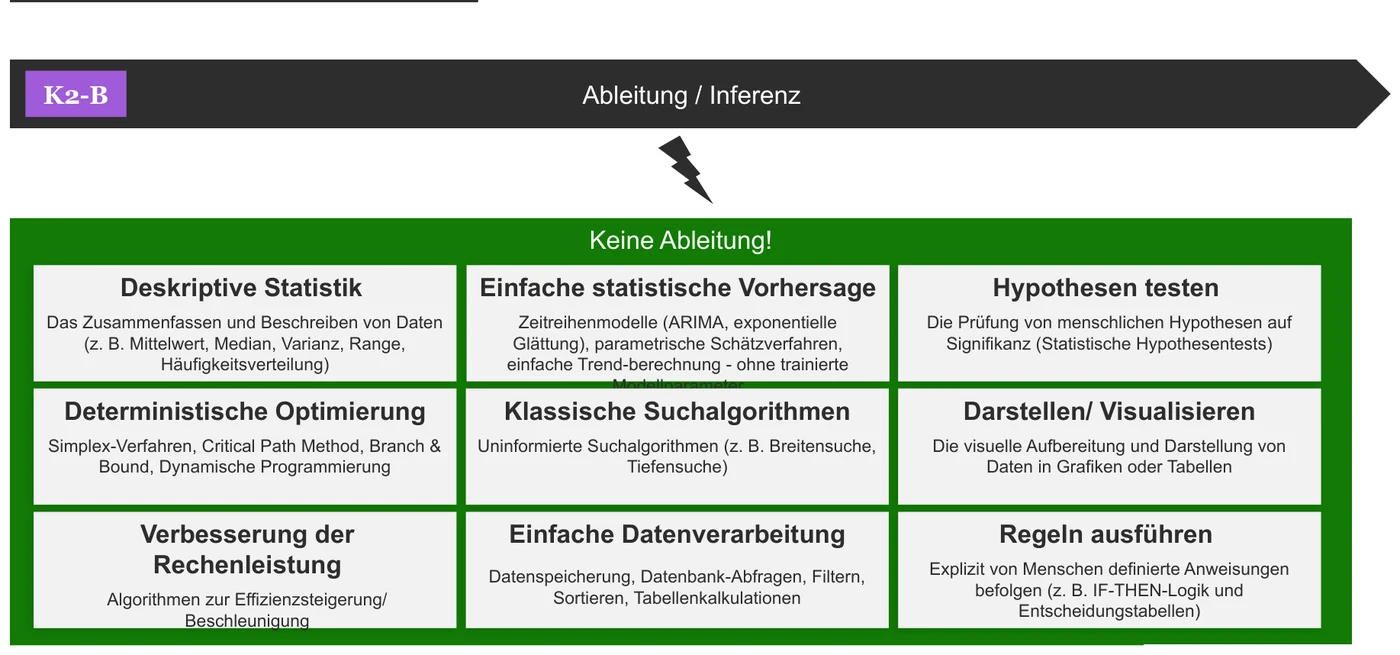
Eine fast ebenso spannende Frage für die Definition von KI-Systemen ist, was eigentlich nicht unter den Begriff des „Ableitens“ fällt. Die EU-Leitlinien C(2025) 5053 nennen in diesem Zusammenhang mehrere Kategorien von Methoden, die kein „Ableiten“ im Sinne der KI-VO darstellen — darunter deskriptive Statistik, einfache Datenverarbeitung, das reine Ausführen von Regeln, Visualisierung, Hypothesentests, die Verbesserung von Rechenleistung, einfache statistische Vorhersagen, deterministische Optimierung sowie klassische Suchalgorithmen.
Soweit so klar — oder etwa nicht?
Auch hier braucht es eigentlich fundiertes KI-Fachwissen, um beurteilen zu können, welche konkreten Methoden und Use Cases tatsächlich unter diese Ausnahmen fallen – und warum sie das eigentlich tun.
Auf Basis einer Literaturrecherche und einigen wilden Diskussionen mit Claude habe ich mir daher auch hierfür eine Auslegungshilfe erarbeitet. Sie dient dazu, Methoden künftig bewusst nicht als KI-Methoden im Sinne der Verordnung einzuordnen.
Für jemanden mit einem Hintergrund in Statistik oder Operations Research sind das vermutlich „low hanging fruits“ — für mich hatte dieser Erkenntnisschritt jedoch fast schon den Charakter einer eigenen kleinen Abschlussarbeit;-)
Aber wo liegt dann die Grenze? Der Graubereich
Doch wer glaubt, damit sei der Durchbruch erreicht, der irrt – denn genau hier wird es nochmal schwieriger. Zwischen den zweifelsfreien KI-Methoden des Ableitens und den eindeutigen „Nicht-KI-Methoden“ liegt nämlich noch eine Unmenge an Methoden im Graubereich.
Ich habe mich hierzu intensiv mit der deutschen „Normungsroadmap KI“ sowie weiteren Fachquellen auseinandergesetzt und dabei Themen identifiziert, bei denen selbst auf wissenschaftlicher Ebene keine Einigkeit besteht. Wie sollte da eine „KI-interessierte Fachkraft“ wie ich zu einer belastbaren, abschließenden Einordnung gelangen?
Aktuell kann ich den Graubereich daher nur umreißen. Letztlich wird wohl erst die Praxis zeigen, wie wir künftig damit umgehen. Dieses Spannungsfeld betrifft vor allem:
- Methoden der nicht-deterministischen Optimierung, etwa evolutionäre oder genetische Algorithmen,
- probabilistisches Schließen, wie Fuzzy-Logik oder Bayes’sche Netze,
- Grenzfälle klassischer Problemlösungsverfahren, etwa A*-Suche oder Greedy-Algorithmen, und
- statistische Lernverfahren wie lineare oder logistische Regression – also Algorithmen, die aus Daten Zusammenhänge erkennen, auf dieser Basis Vorhersagen treffen und auf statistischen auf statistischen Modellen beruhen.
Das Prüfschema
Aus all diesen Erkenntnissen habe ich ein dreistufiges Prüfschema abgeleitet: Zuerst werden die Kernkriterien K1 bis K3 geprüft, bei Bedarf auch die Ergänzungskriterien E1 bis E5, und schließlich erfolgt die Einstufung als „Definitiv KI“, „KI-Grenzfall“ oder „Keine KI“.
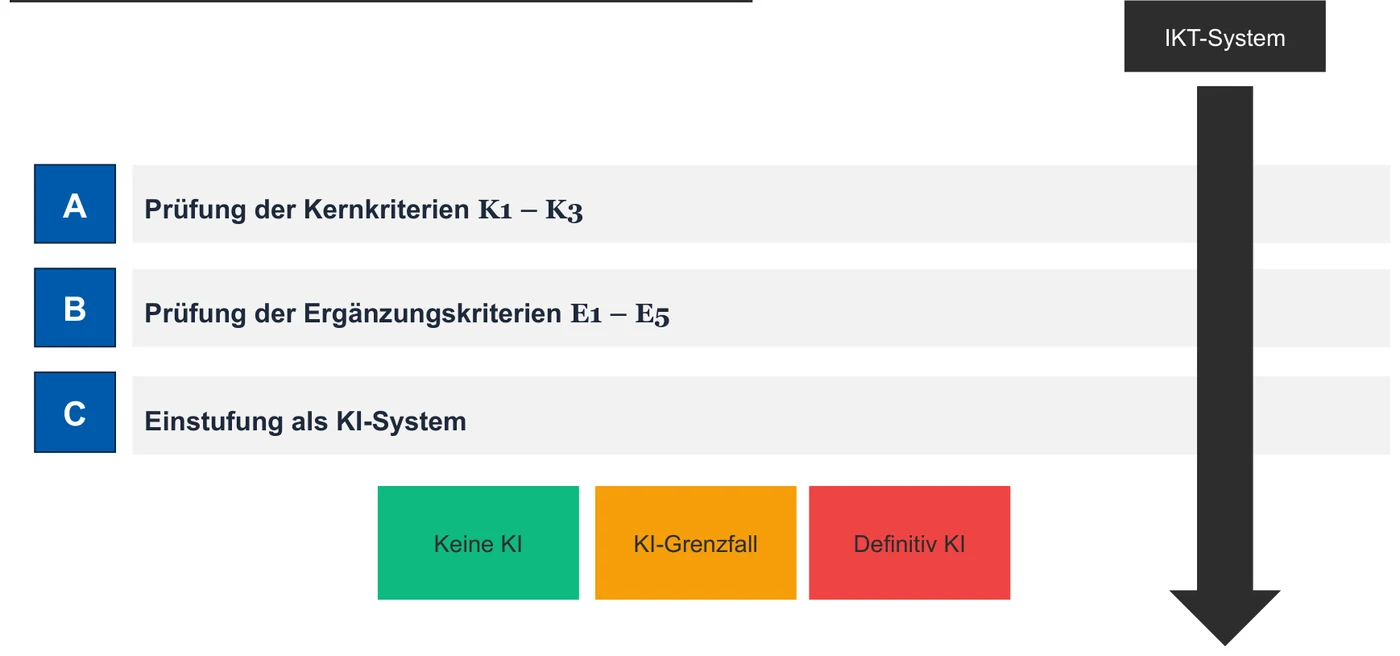
Prüfung der Kernkriterien
Im ersten Schritt werden die Kernkriterien systematisch bewertet:
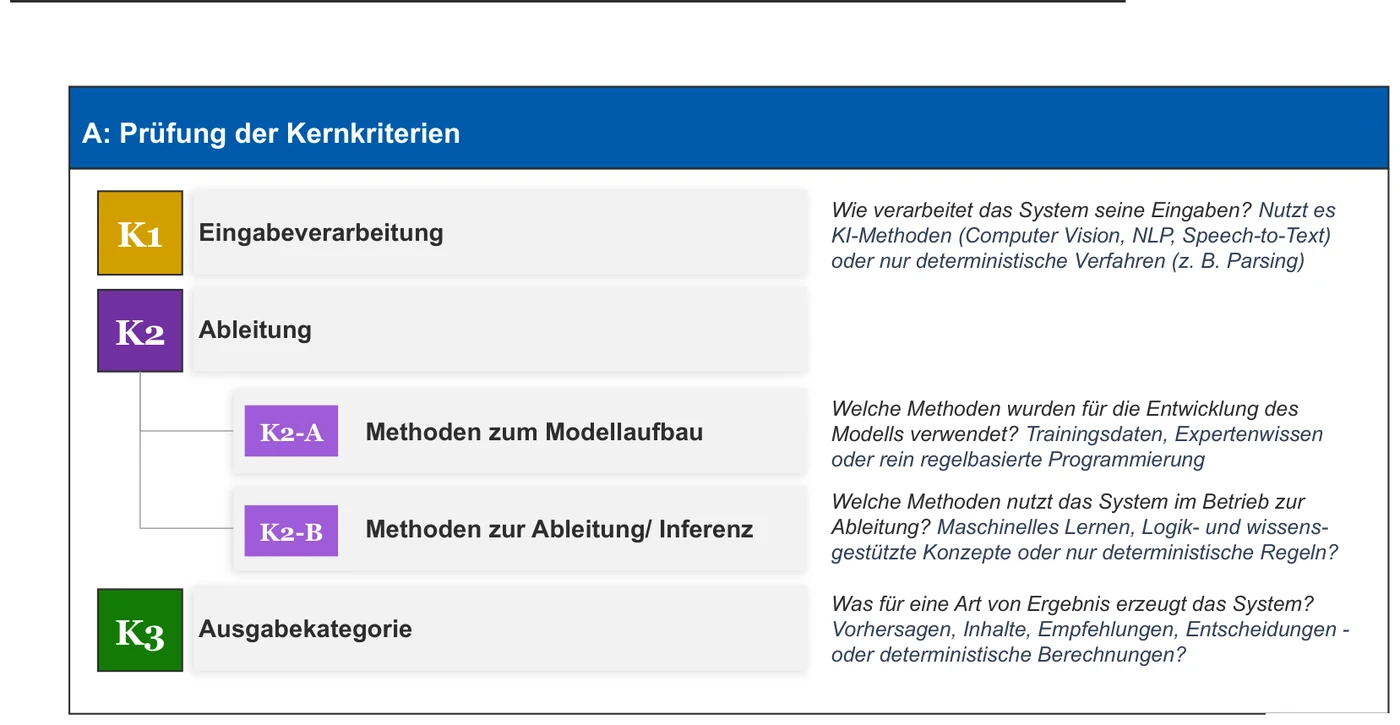
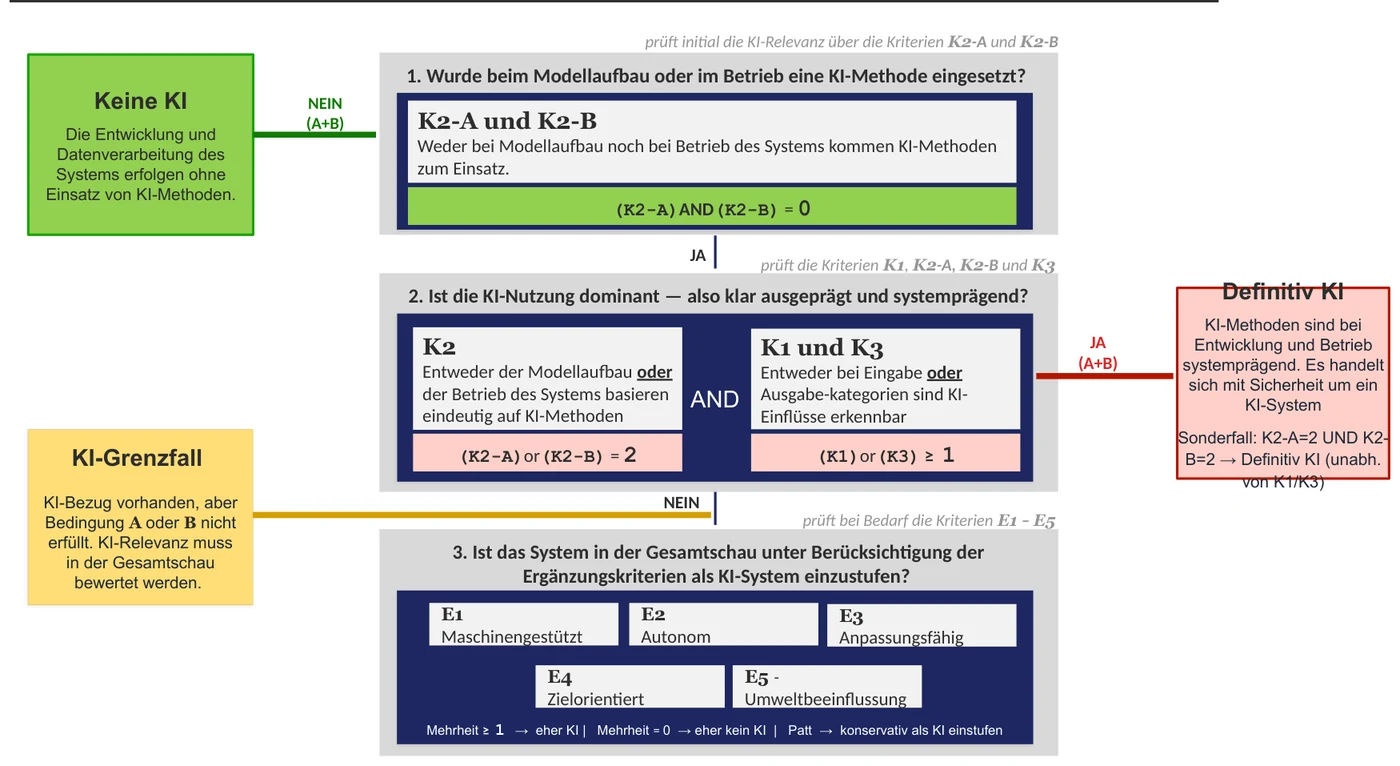
Bei der Auswertung wende ich ein „Gatekeeper-Prinzip“ bei K2 (Ableitung) an: Sobald beim Aufbau oder Betrieb des Systems eine KI-Methode zum Einsatz kommt, ist dies ein starkes Indiz für ein KI-System. Wenn sich der Einsatz von KI-Methoden ausschließen lässt, handelt es sich nicht um KI.
Anschließend wird geprüft, ob KI-Methoden bereits bei Eingabe oder Ausgabe erkennbar sind. Wenn beispielsweise die Datenerfassung auf Methoden wie Speech-to-Text oder Computer Vision basiert, ist die Einordnung als KI-System sehr wahrscheinlich. Werden die Systemausgaben zudem in den Kategorien Empfehlungen, Vorhersagen, Inhalte oder Entscheidungen gemäß KI-Verordnung erzeugt, gilt die Einstufung als KI-System als abgeschlossen.
Sollten Zweifel bestehen und ein KI-Grenzfall vorliegen, ist eine abschließende Bewertung nur durch eine Gesamtabwägung unter Einbeziehung der Ergänzungskriterien E1 bis E5 möglich.
Von der Methode zum Werkzeug
Dieses Prüfschema habe ich inzwischen in einen Claude-Skill überführt. Der Skill enthält eine umfassende Methodenbeschreibung, einen Referenzkatalog mit über 40 bewerteten KI- und Nicht-KI-Methoden sowie mehr als 100 Beispielen zur Kalibrierung der Analyse.
Das Ergebnis: Eine KI-Prüfung, die mich manuell Stunden kosten würde, läuft in Sekunden — fundiert, nachvollziehbar und wiederholbar. Nun folgen die Praxistests und ich bin gespannt, wie diese verlaufen werden:-)
Wenn ihr dazu auf dem Laufenden bleiben wollt, abonniert gerne meinen Newsletter und folgt meinem Linkedin-Profil. Ich werde weiter berichten!
Habt einen guten Start in die neue Woche und bis bald.